
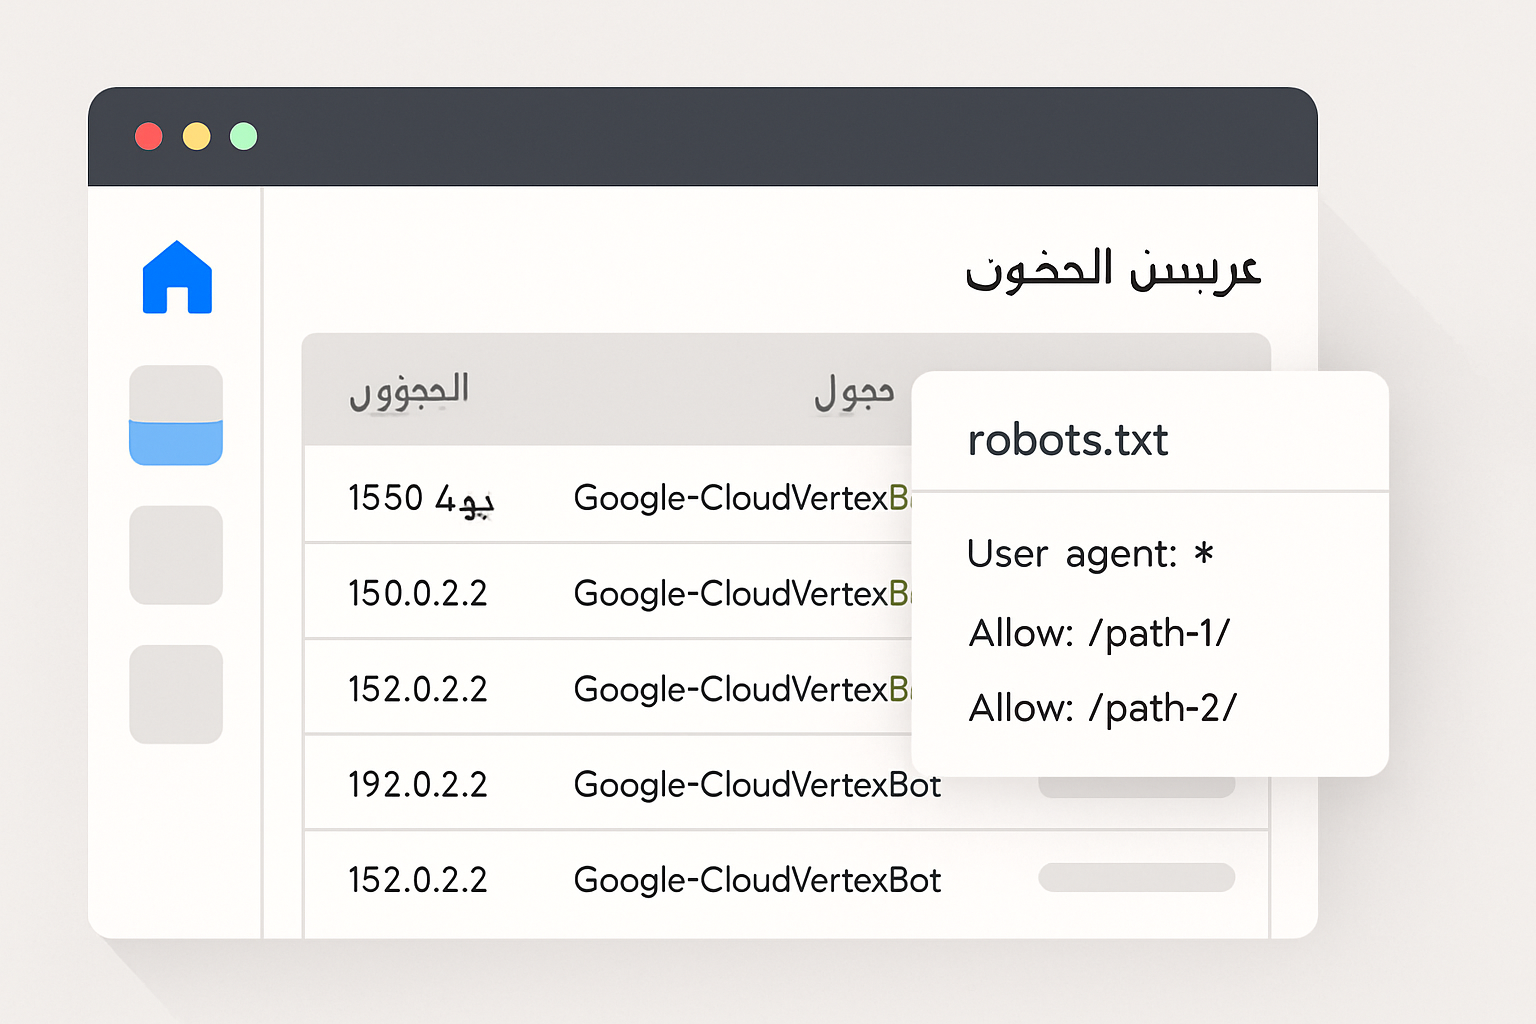
أطلقت جوجل زاحفًا رسميًا جديدًا باسم Google-CloudVertexBot يظهر فقط عندما يطلب مالك الموقع فهرسة محتوى موقعه لخدمة الوكلاء الذكيين (Vertex AI Agents/Agent Search). الأهم: هذا الزاحف ليس جزءًا من فهرسة Google Search المعتادة، بل هو قناة منفصلة تُدار بناءً على موافقة المالك، ويحترم robots.txt. وفي المقابل يمكن ضبط استخدام المحتوى في تدريب النماذج عبر Google-Extended بشكل مستقل. في هذا الدليل العملي نوضح ما الذي تغيّر في وثائق جوجل، من المتأثر، وما الذي ينبغي فعله الآن للمواقع العربية.
ما الذي تغيّر؟
- إدراج Google-CloudVertexBot ضمن قائمة «الزواحف الشائعة» في وثائق جوجل الرسمية، مع نص صريح أنه يؤثر فقط على عمليات الزحف المطلوبة لبناء Vertex AI Agents ولا يؤثر على Google Search أو المنتجات الأخرى. كما حُدِّثت الصفحة في 14 يوليو 2026 لتشمل اسم وكيل المستخدم وكيفية التحكم به عبر robots.txt.
- وثائق «Search updates» لدى Google Search Central تضيف إشعارًا يعرّف بالزاحف الجديد ويوضح أنه مخصص لعمليات الزحف بطلب مالك الموقع عند بناء وكلاء Vertex AI، بهدف تسهيل تمييزه في السجلات.
- وثائق Google Cloud (Agent Search) تؤكد أن Google-CloudVertexBot يحتاج للوصول إلى المحتوى — بما في ذلك المحتوى المحجوب باشتراك — عند قيامك بإعداد فهرسة موقعك للوكلاء، وتعرض مثال وكيل المستخدم وطريقة السماح له في robots.txt.
- توضيح إضافي من جوجل في يونيو 2026 حول
llms.txt: هذا الملف ليس مطلوبًا ولا يستخدمه Google Search، ولن يؤثر وجوده أو عدمه على الترتيب — لتفادي اللبس بين سياسات الزحف التقليدية وضوابط أنظمة الذكاء الاصطناعي.
من المتأثر؟
أي مؤسسة عربية تخطط لبناء تجارب بحث ذكي أو "وكلاء" على Vertex AI اعتمادًا على محتوى مواقعها، مثل:
- الناشرون ووسائل الإعلام التي ترغب في تمكين البحث الدلالي داخل الأرشيف، مع استمرار حماية المحتوى المدفوع.
- متاجر التجارة الإلكترونية التي تريد تمكين وكيل محادثي يجيب عن أسئلة المستخدم من صفحات المنتجات وسياسات الشحن والإرجاع.
- الهيئات والمؤسسات التعليمية والبوابات الحكومية التي تنوي تقديم إجابات موثوقة مستندة إلى وثائقها المنشورة.
لماذا يهمني الآن؟
لأنك أصبحت قادرًا على التحكم الدقيق في مسارات الزحف الموجهة للوكلاء الذكيين بمعزل عن زحف Google Search التقليدي. هذا يعني:
- تحسين الدقة والجودة داخل تطبيقات RAG/الوكلاء دون التأثير على ظهورك في نتائج البحث العامة.
- تقليل التكلفة عبر تقييد الفهرسة إلى أنماط عناوين URL ذات القيمة، وفق ضوابط وثائق Agent Search (مثلاً تجنب فهرسة عناوين البحث الديناميكية والروابط المكررة).
- حماية حقوق المحتوى عبر الجمع بين السماح للوكلاء بالزحف ومنع استخدام المواد لأغراض تدريب النماذج باستخدام
Google-Extendedإذا رغبت.
ماذا أفعل الآن؟ خطوات عملية مُقترحة
1) ضبط robots.txt لتمييز Google-CloudVertexBot
أضف قواعد صريحة للزاحف الجديد. أمثلة عملية:
- السماح الكامل للوكلاء بالزحف إلى مستودع المعرفة العام:
user-agent: Google-CloudVertexBot
allow: /knowledge-base/ - حصر الزحف في مسارات محددة ومنع بقية الأقسام:
user-agent: Google-CloudVertexBot
disallow: /search?
disallow: /user/
allow: /docs/ - منع الزحف نهائيًا (إن لم تكن تخطط لاستخدام Vertex AI Agents):
user-agent: Google-CloudVertexBot
disallow: /
وفق وثائق جوجل، Google-CloudVertexBot يحترم robots.txt بوصفه زاحفًا «شائعًا». لذا فاعتماد قواعد واضحة سيجنّبك الفهرسة غير المرغوبة.
2) تحقّق من هوية الزائر في السجلات
وفّر تحققًا تلقائيًا من عناوين IP ونطاقات العكس (rDNS) الخاصة بزواحف جوجل. تتضمن وثائق جوجل طريقتين: التحقق اليدوي عبر host للسجل العكسي ثم الأمامي، أو المطابقة التلقائية مع قوائم JSON الرسمية لعناوين IP للزواحف الشائعة والخاصة وجلبات المستخدم. هذا يقلل الانتحال ويحمي بوابتك من جهات تُقلّد وكيل المستخدم.
3) إدارة المحتوى المحجوب باشتراك دون خرق السياسات
إذا أردت أن يستهلك الوكيل الذكي محتوىً محجوبًا باشتراك، فتأكّد من أمرين:
- السماح صراحةً لـ Google-CloudVertexBot في robots.txt كما توصي وثائق Agent Search، وهو يحتاج للوصول لاستخراج المعرفة.
- ترميز الأقسام المحجوبة وفق إرشادات «المحتوى المدفوع/الاشتراك» في Google Search Central لمنع اعتبار ذلك «إخفاءً للمحتوى». استخدم
isAccessibleForFree:falseوhasPart.cssSelectorلتحديد طبقات الجدار المدفوع بدقة.
4) خفّض الكلفة وارفع الجودة قبل الفهرسة
وثائق Agent Search توضّح حدود أنماط العناوين لكل وضع (حتى 50 نمطًا في البحث الأساسي و500 للنطاق المتقدم)، وتحذّر من فهرسة عناوين ديناميكية أو مكررة لأنها تُضخّم التكلفة وتضعف جودة النتائج. راجع «مواقع للاستثناء» واستفد من canonical لتفادي النسخ المكررة (مثل مسارات المنتدى البديلة أو روابط المعاينات).
5) افصل بين «الزحف للوكلاء» و«استخدام المحتوى لتدريب النماذج»
لديك ذراع تحكم مستقل اسمه Google-Extended في robots.txt. هذا الرمز لا يؤثر على ظهورك في بحث جوجل، لكنه يسمح لك بتقييد استخدام المحتوى في تدريب نماذج Gemini أو في عمليات «الاستناد/الـ Grounding» ضمن منصات جوجل. بهذا يمكنك — مثلًا — السماح لـ Google-CloudVertexBot بالزحف لمحتوى الدعم الفني، مع منع استخدام نفس المحتوى في تدريب النماذج.
فروقات أساسية يجب إدراكها
- Google-CloudVertexBot: زاحف يُستخدم عند طلب المالك لفهرسة موقعه من أجل Vertex AI Agents/Agent Search؛ يحترم robots.txt؛ لا يؤثر على Google Search.
- Googlebot وأقسامه (الصور/الفيديو/الأخبار): زحف وفهرسة للبحث العام؛ تحكمها سياسات Search وتظهر في Search Console.
- Google-Extended: رمز تحكم لتقييد استخدام المحتوى في تدريب النماذج والـ Grounding، ولا يغيّر الزحف بحد ذاته.
أمثلة تهيئة عملية
سيناريو 1 — تمكين وكيل دعم عربي مع حصر التكاليف
اسمح للزاحف فقط ضمن أدلة الأسئلة الشائعة والمستندات، واحظر الاستعلامات الديناميكية:
user-agent: Google-CloudVertexBot
allow: /ar/docs/
allow: /ar/faq/
disallow: /search?
disallow: /cart/
user-agent: Google-Extended
disallow: /
النتيجة: الوكيل يصل للمحتوى المهم دون تضخيم الفواتير؛ ويُمنع استخدام المواد لتدريب النماذج.
سيناريو 2 — ناشر لديه محتوى مدفوع
اسمح للزاحف بالوصول للأقسام المدفوعة، وأضف ترميز «المحتوى خلف الجدار» بما يتوافق مع سياسات جوجل:
user-agent: Google-CloudVertexBot
allow: /premium/
disallow: /search?
ثم طبّق isAccessibleForFree:false وhasPart.cssSelector على عناصر الجدار، كي لا يُعد ذلك «إخفاءً». بهذا تمنح وكيلك الذكي القدرة على الإجابة الدقيقة دون الإخلال بسياسات محركات البحث.
أسئلة سريعة
هل سيؤثر هذا على ترتيبي في Google Search؟
لا. وثائق جوجل تنص أن Google-CloudVertexBot «لا تأثير له على Google Search أو المنتجات الأخرى». تحكم الزاحف يتم بمعزل عن فهرسة البحث العامة.
كيف أتأكد أن الطلبات فعلاً من جوجل؟
تحقق من rDNS ثم أعد الحلّ للأمام، أو طابق عناوين IP مع ملفات JSON الرسمية للزواحف الشائعة والخاصة وجلبات المستخدم. وفّر ذلك كقواعد تلقائية في بوابة WAF أو عبر سجلّات الخادم.
هل أحتاج إلى llms.txt؟
لا لاحتياجات Google Search؛ وقد أوضحت جوجل في يونيو 2026 أن llms.txt ليس مطلوبًا ولا يؤثر على الظهور أو الترتيب. اعتمد robots.txt وGoogle-Extended لضبط التدريب، وrobots.txt لقواعد الزحف.
الخلاصة
يوفّر Google-CloudVertexBot للمواقع العربية مسارًا رسميًا وآمنًا لتغذية الوكلاء الذكيين بالمحتوى المناسب دون المساس بفهرسة البحث العامة. ابدأ بمراجعة robots.txt، وثّق هوية الزائر، حافِظ على جودة الفهرسة بتجنّب العناوين الديناميكية والروابط المكررة، واضبط سياسة التدريب عبر Google-Extended حسب ما يناسب عملك. بهذه الخطوات ستستفيد من قدرات Vertex AI Agents بأقل مخاطر وكلفة، وبما يضمن الامتثال لسياسات جوجل.
المصادر الرسمية
- قائمة الزواحف الشائعة لدى جوجل (تتضمن Google-CloudVertexBot وGoogle-Extended)
- آخر تحديثات وثائق بحث جوجل (إدراج Google-CloudVertexBot وتوضيحات ذات صلة)
- Google Cloud Agent Search: تهيئة بيانات الموقع للزحف والفهرسة (مع وكيل المستخدم وقواعد robots.txt)
- التحقق من طلبات زواحف وجوالب جوجل (rDNS وملفات JSON لعناوين IP)
- ترميز المحتوى المحجوب باشتراك في Google Search Central
 أفضل مواقع وأدوات تحويل ملفات PDF إلى Word وتلخيصها بالذكاء الاصطناعي 2026
 أفضل أدوات الذكاء الاصطناعي للطلاب والمعلمين في السعودية 2026
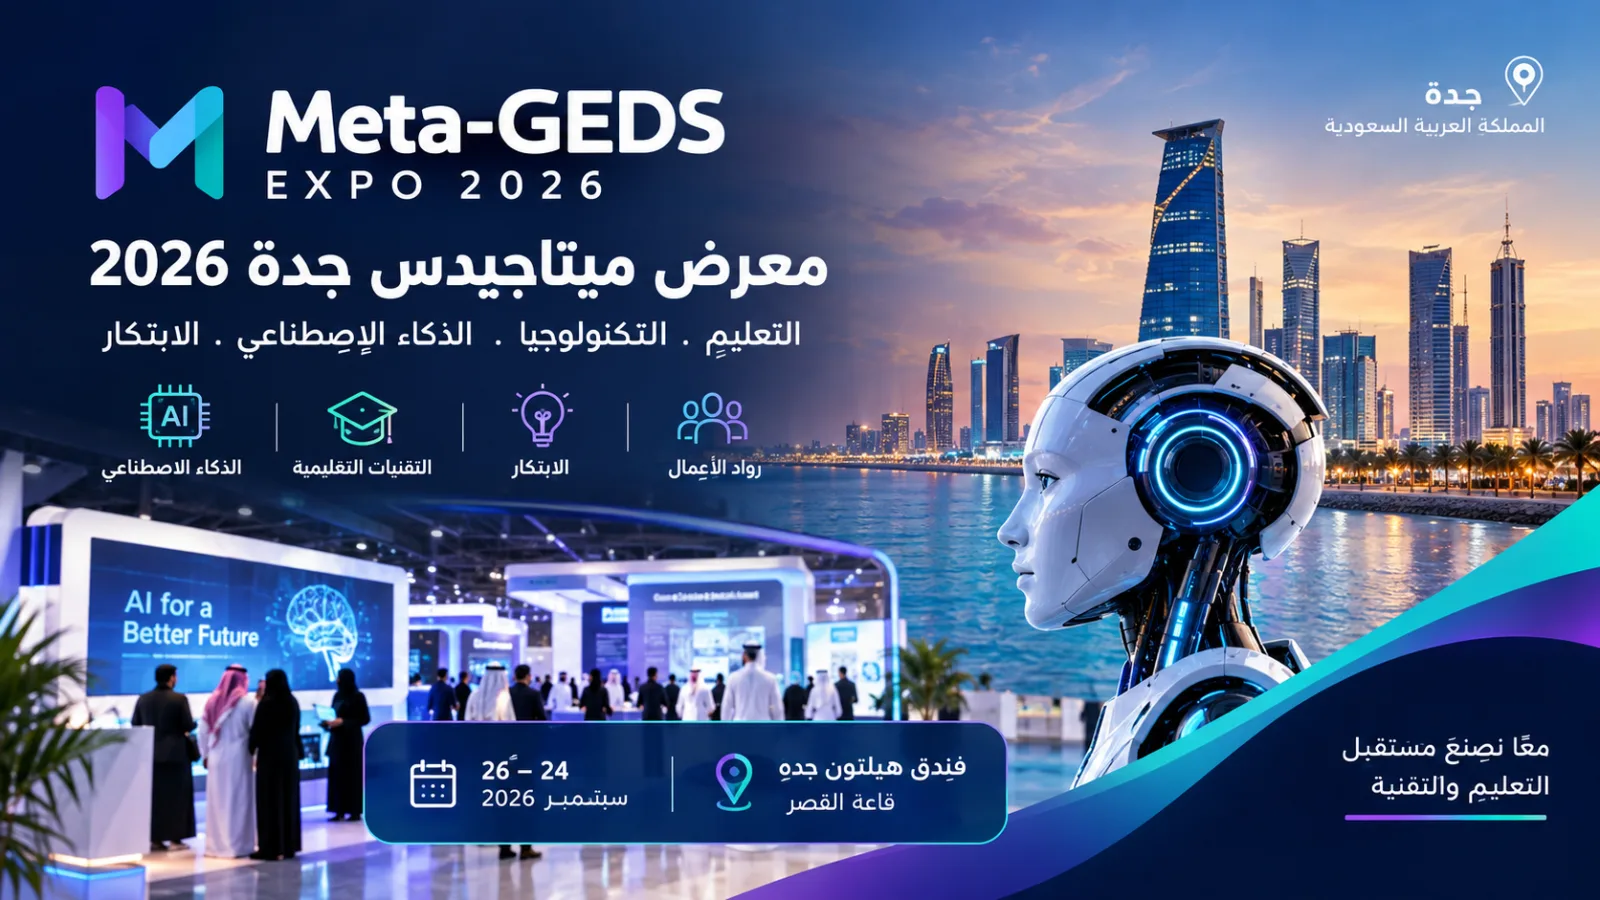 معرض ميتاجيدس جدة 2026: الموعد والمكان وأبرز فعاليات الذكاء الاصطناعي والتقنية التعليمية
 تحديثات ChatGPT في 2026: حجز المطاعم مباشرة وأبرز المزايا الجديدة التي تهم المستخدم العربي